Glossario delle metriche di rete e QoS per i responsabili delle telecomunicazioni
Latenza, jitter, perdita di pacchetti e larghezza di banda descrivono aspetti diversi delle prestazioni di una rete. Questo glossario spiega come interpretarli insieme alla QoS e all’esperienza utente per orientare la gestione operativa.
La qualità del servizio (QoS) comprende politiche e meccanismi di rete che classificano e danno priorità al traffico per gestire le risorse disponibili e offrire prestazioni più prevedibili. È particolarmente rilevante quando applicazioni diverse condividono la capacità e hanno esigenze differenti: una chiamata vocale è sensibile ai ritardi, mentre un trasferimento di file in genere li tollera meglio.
La QoS descrive le condizioni tecniche della rete; la qualità dell’esperienza (QoE) si riferisce a come l’utente percepisce il servizio. Le metriche di rete possono aiutare a spiegare un’esperienza insoddisfacente, ma non la rappresentano del tutto: la soddisfazione dipende anche dall’applicazione e dalle aspettative dell’utente.
Glossario delle metriche principali
Larghezza di banda e throughput
La larghezza di banda è la capacità di trasmissione disponibile o assegnata a un collegamento o a un flusso, solitamente espressa in bit al secondo, per esempio Mbps o Gbps. Non equivale necessariamente alla velocità raggiunta da ogni applicazione: il risultato dipende dalla capacità condivisa, dalla congestione e dalla configurazione della rete.
Per la gestione operativa, è utile distinguere la capacità del collegamento dal volume di dati effettivamente trasmesso. Una rete può disporre di larghezza di banda sufficiente e offrire comunque un’esperienza insoddisfacente se presenta latenza elevata, variazioni o perdite.
Latenza
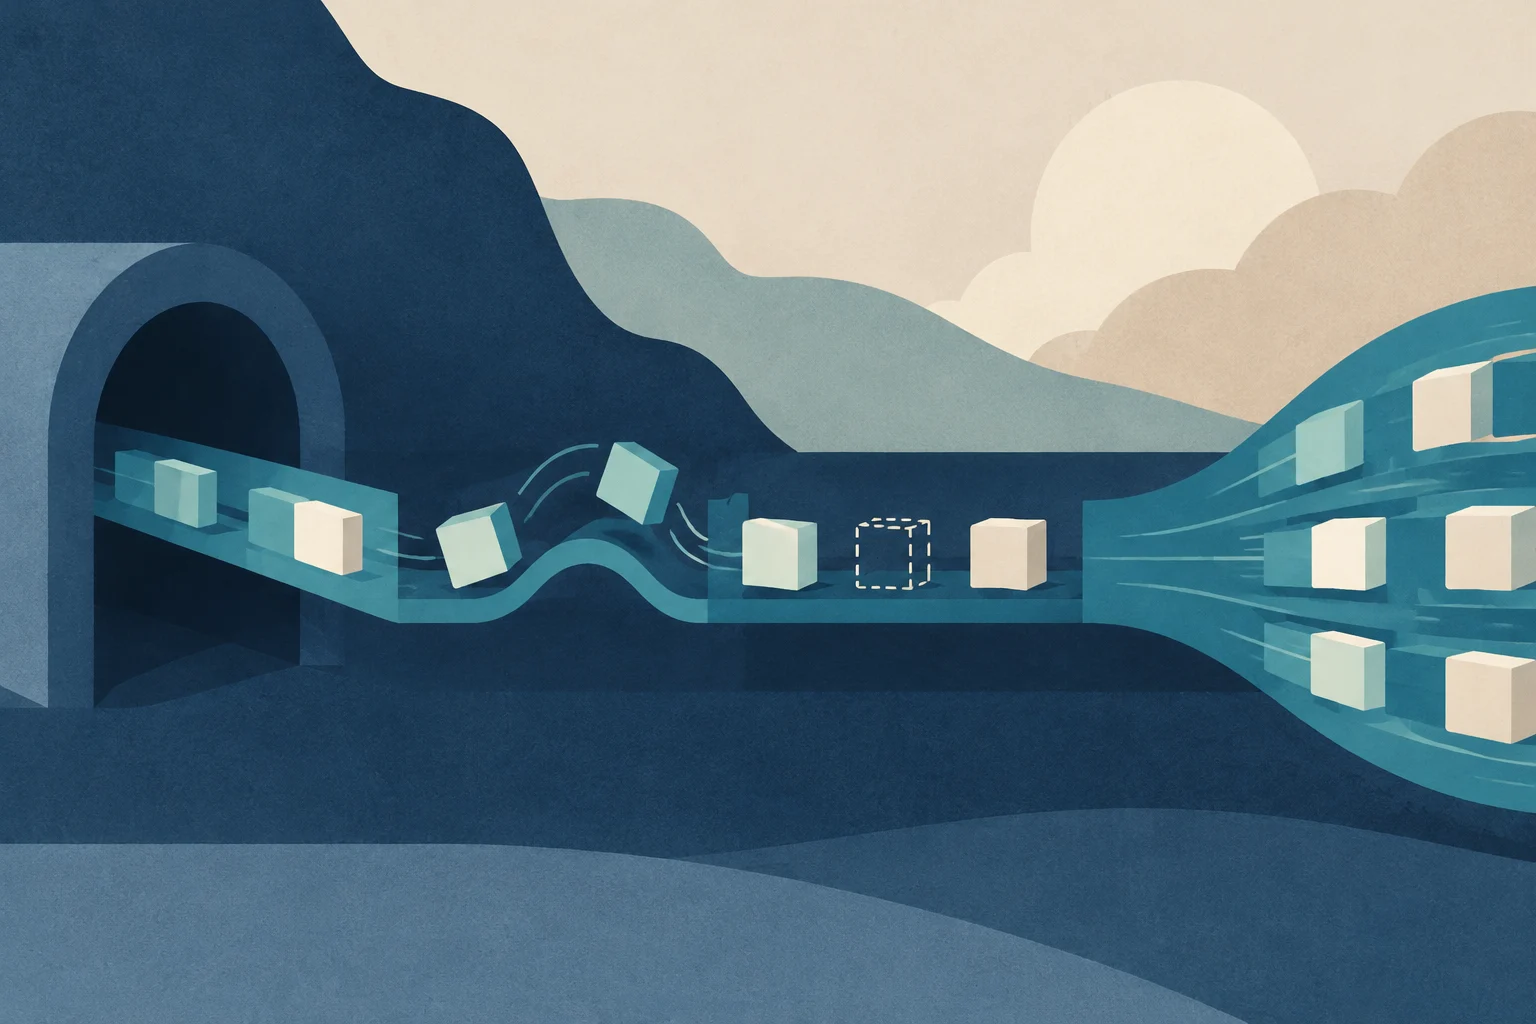
La latenza è il tempo impiegato da un pacchetto per viaggiare dalla sorgente alla destinazione. Può aumentare, per esempio, quando i pacchetti rimangono in coda durante i periodi di congestione. Si esprime abitualmente in millisecondi (ms).
Come riferimenti indicativi per le applicazioni interattive, ManageEngine segnala che sotto i 50 ms il ritardo tende a passare inosservato; tra 50 e 150 ms possono comparire pause percepibili e oltre 150 ms la conversazione può risentirne in modo più evidente. Non si tratta di soglie universali: l’impatto dipende dall’applicazione, dal percorso e dalle condizioni di misurazione. Durante una chiamata, un ritardo elevato può rendere difficile alternarsi nel parlare.
Jitter o variazione
Il jitter, chiamato anche variazione, descrive quanto cambia il ritardo tra i pacchetti. Non è la stessa cosa della latenza: una connessione può avere un ritardo medio moderato e, tuttavia, presentare variazioni significative tra pacchetti successivi.
Questa variabilità può influire sull’audio e sul video in tempo reale, perché i dati non arrivano a un ritmo costante. Perciò, quando si diagnosticano interruzioni o scatti durante una videochiamata, esaminare soltanto la latenza media può non essere sufficiente.
Perdita di pacchetti
La perdita di pacchetti è la proporzione di pacchetti inviati che non raggiunge la destinazione. Può interrompere o degradare le comunicazioni, soprattutto quando l’applicazione deve ricevere dati in modo continuo. Va valutata insieme alla latenza e al jitter: un valore isolato non spiega da solo né la causa né l’impatto sull’utente.
Affidabilità
L’affidabilità descrive la capacità della rete di fornire il servizio in modo coerente e senza interruzioni rilevanti. È un concetto più ampio di una misurazione puntuale: per valutarla può essere necessario osservare il comportamento della rete nel tempo e in diverse condizioni di carico.
Illustrazione concettuale generata con IA · Edition Business
Meccanismi di QoS: come viene gestito il traffico
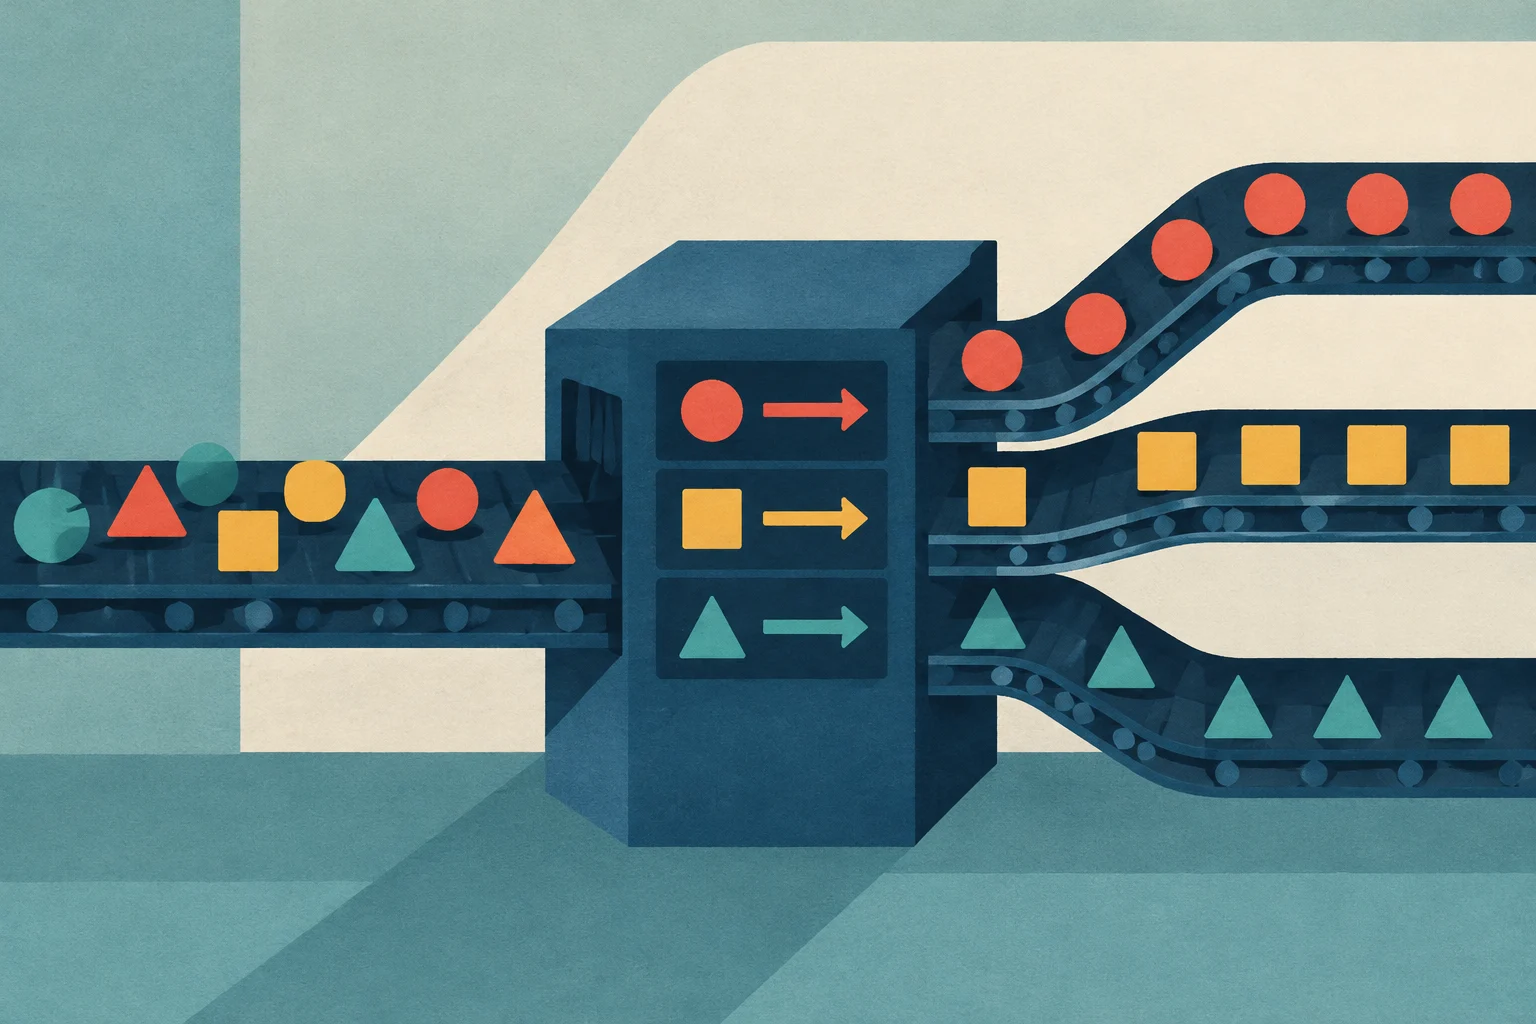
Le reti possono applicare classificazione e prioritizzazione per trattare alcuni flussi prima di altri. Si utilizzano anche code per ordinare i pacchetti, meccanismi di gestione del traffico per regolarne l’invio e controlli di ammissione per limitare le nuove connessioni quando le risorse disponibili non consentono di mantenere i livelli previsti.
Nelle reti congestionate, queste politiche aiutano a distribuire la capacità in base alle esigenze dei servizi. Non creano larghezza di banda aggiuntiva: stabiliscono come utilizzare la capacità esistente e quale traffico debba avere la precedenza. Di conseguenza, una priorità maggiore assegnata a un’applicazione può comportare meno risorse disponibili per un’altra.
Tecnologie come DiffServ consentono di classificare o contrassegnare i pacchetti per applicare politiche differenziate. Perché la prioritizzazione sia efficace da un’estremità all’altra, le apparecchiature e i tratti di rete pertinenti devono poter interpretare e rispettare le politiche configurate. Se viene applicata soltanto a una parte del percorso, il trattamento potrebbe non essere mantenuto nel resto della tratta.
Come interpretare le metriche nel loro insieme
Per i team operativi e di gestione, le metriche sono più utili quando vengono collegate al servizio da proteggere e alla percezione dell’utente. Una videoconferenza, per esempio, può peggiorare a causa di latenza elevata, jitter, perdita di pacchetti o di una combinazione di questi fattori. Aumentare la priorità del traffico può essere d’aiuto nei momenti di congestione, ma non dimostra da solo che il problema sia stato risolto.
Una lettura operativa pratica può seguire quest’ordine:
Individuare il servizio interessato e quando si verifica il peggioramento.
Esaminare congiuntamente latenza, jitter, perdita di pacchetti e utilizzo della capacità nei tratti pertinenti.
Verificare le politiche QoS e se le apparecchiature di rete le applicano lungo il percorso.
Confrontare gli indicatori con l’esperienza osservata, senza presumere che un’unica metrica spieghi tutti i problemi.
Il monitoraggio e l’analisi del traffico possono aiutare a individuare i colli di bottiglia e a verificare se le politiche funzionano. L’interpretazione deve tenere conto del tipo di applicazione, della direzione di trasmissione e delle condizioni in cui sono stati raccolti i dati.
Limiti e sfide della gestione QoS
La configurazione della QoS può essere complessa e richiede il coordinamento delle politiche tra dispositivi e tecnologie. Inoltre, i modelli di traffico cambiano: una configurazione efficace in un periodo di basso carico potrebbe non dare lo stesso risultato quando la domanda aumenta. Anche la compatibilità tra le apparecchiature e la copertura delle politiche lungo l’intero percorso ne condizionano l’efficacia.
Perciò la QoS non va intesa come garanzia assoluta di una determinata esperienza. È uno strumento per gestire priorità e risorse; il risultato dipende dalla capacità disponibile, dalla progettazione della rete, dalla configurazione applicata e dalle esigenze specifiche di ciascun servizio.
Una guida pratica per individuare gli squilibri, definire le priorità e riassegnare le attività in base alla reale capacità del team, non solo al numero di attività in sospeso.
Scopri come utilizzare il diagramma SIPOC e le mappe di flusso per allineare i team, definire l'ambito di un processo e rilevare le inefficienze nella tua PMI senza cadere nella burocrazia eccessiva.
Un glossario pratico di tre indicatori essenziali per analizzare prezzi e domanda, calcolare i ricavi per camera disponibile ed evitare conclusioni incomplete sulle prestazioni.