Glossaire des métriques réseau et de la QoS pour les responsables télécoms
La latence, la gigue, la perte de paquets et la bande passante décrivent différents aspects des performances d’un réseau. Ce glossaire explique comment les interpréter avec la QoS et l’expérience utilisateur afin d’orienter la gestion opérationnelle.
La qualité de service (QoS) regroupe des politiques et des mécanismes réseau qui classent et priorisent le trafic afin de gérer les ressources disponibles et d’offrir des performances plus prévisibles. Elle est particulièrement importante lorsque différentes applications partagent une même capacité tout en ayant des besoins distincts : un appel vocal est sensible aux retards, tandis qu’un transfert de fichiers les tolère généralement mieux.
La QoS décrit les conditions techniques du réseau ; la qualité de l’expérience (QoE) désigne la façon dont la personne utilisatrice perçoit le service. Les métriques réseau peuvent aider à expliquer une expérience insatisfaisante, mais elles ne la représentent pas entièrement : la satisfaction dépend également de l’application et des attentes de l’utilisateur.
Glossaire des principales métriques
Bande passante et débit
La bande passante correspond à la capacité de transmission disponible ou attribuée à une liaison ou à un flux. Elle est généralement exprimée en bits par seconde, par exemple en Mbps ou en Gbps. Elle n’équivaut pas nécessairement à la vitesse obtenue par chaque application : la capacité partagée, la congestion et la configuration du réseau influent sur le résultat.
Pour la gestion opérationnelle, il convient de distinguer la capacité de la liaison du volume de données effectivement transmis. Un réseau peut disposer d’une bande passante suffisante et pourtant offrir une expérience insatisfaisante en raison d’une latence élevée, de fluctuations ou de pertes.
Latence
La latence est le temps nécessaire à un paquet pour aller de sa source à sa destination. Elle peut augmenter, par exemple, lorsque les paquets attendent dans des files pendant les périodes de congestion. Elle s’exprime généralement en millisecondes (ms).
À titre indicatif pour les applications interactives, ManageEngine indique qu’en dessous de 50 ms, le retard passe généralement inaperçu ; entre 50 et 150 ms, des pauses perceptibles peuvent apparaître ; au-delà de 150 ms, la conversation peut être plus nettement affectée. Ces valeurs ne constituent pas des limites universelles : l’impact dépend de l’application, du trajet et des conditions de mesure. Lors d’un appel, un retard important peut empêcher les personnes de prendre la parole à tour de rôle.
Gigue ou fluctuation
La gigue décrit l’ampleur des variations du délai entre les paquets. Elle n’est pas identique à la latence : une connexion peut avoir un délai moyen modéré tout en présentant des variations importantes d’un paquet au suivant.
Cette variabilité peut affecter l’audio et la vidéo en temps réel, car les données n’arrivent pas à un rythme constant. Ainsi, pour diagnostiquer des coupures ou des saccades lors d’un appel vidéo, l’examen de la seule latence moyenne peut être insuffisant.
Perte de paquets
La perte de paquets est la proportion des paquets envoyés qui n’atteignent pas leur destination. Elle peut interrompre ou dégrader les communications, notamment lorsque l’application doit recevoir les données en continu. Il faut l’examiner avec la latence et la gigue : une valeur isolée ne suffit pas à expliquer la cause du problème ni son impact sur l’utilisateur.
Fiabilité
La fiabilité désigne la capacité du réseau à fournir le service de manière constante et sans interruptions importantes. Il s’agit d’un concept plus large qu’une mesure ponctuelle : son évaluation peut nécessiter d’observer le comportement du réseau dans la durée et dans différentes conditions de charge.
Illustration conceptuelle générée par IA · Edition Business
Mécanismes de QoS : comment le trafic est géré
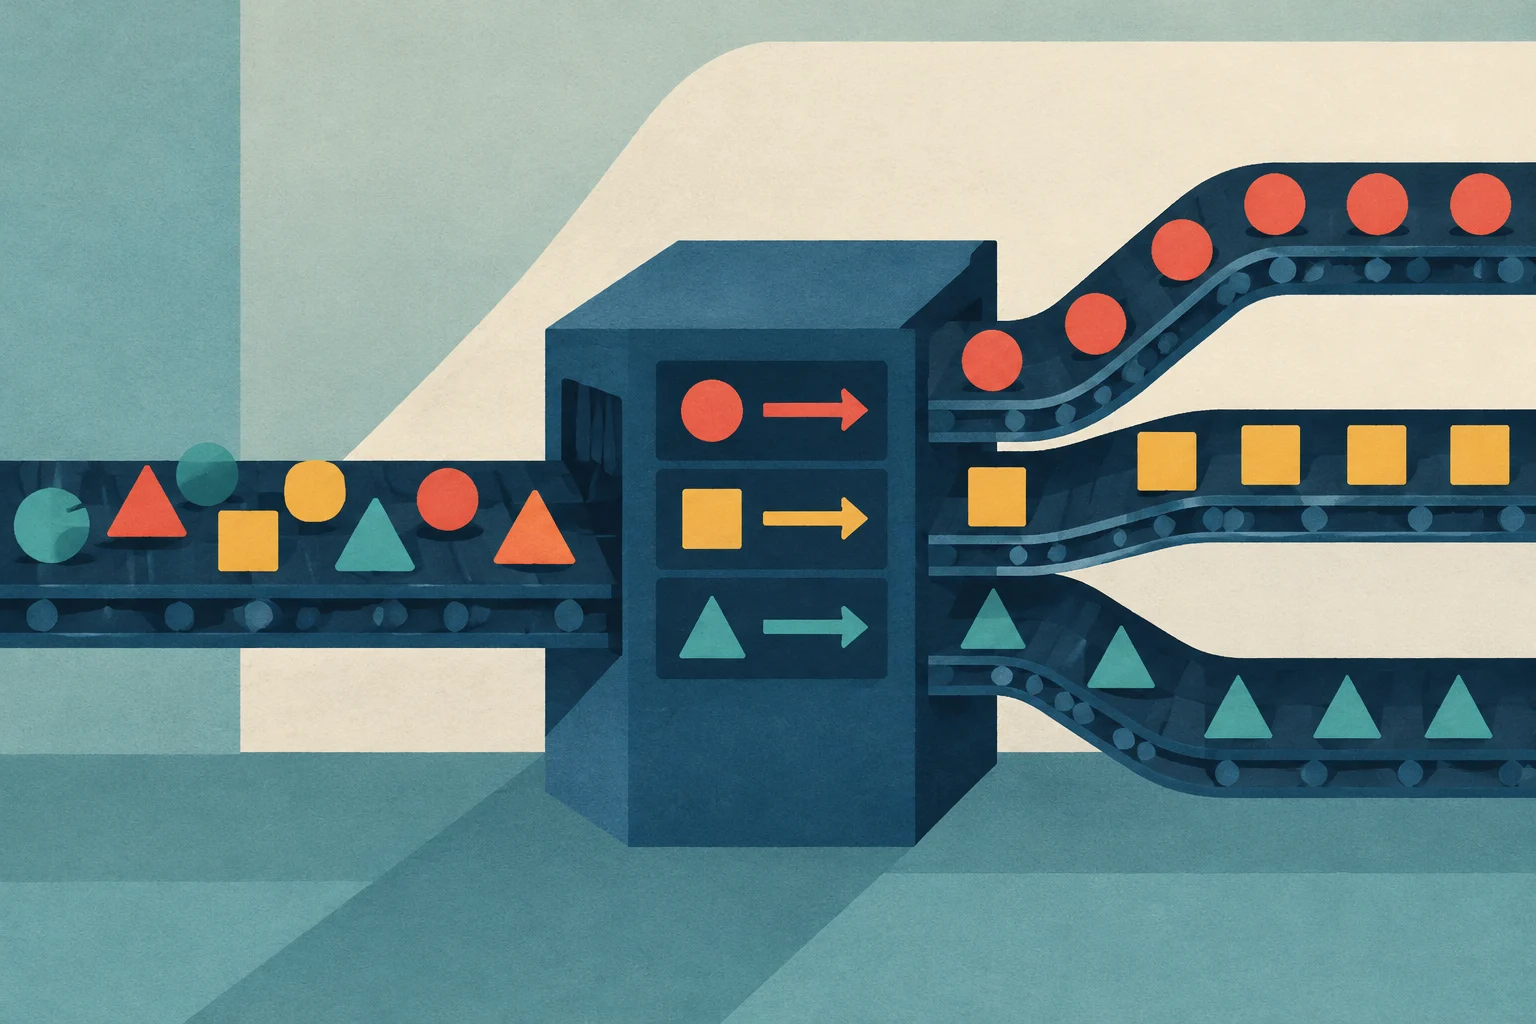
Les réseaux peuvent appliquer la classification et la priorisation afin de traiter certains flux avant d’autres. Des files d’attente servent également à ordonner les paquets, des mécanismes de gestion du trafic à réguler les envois et des contrôles d’admission à limiter les nouvelles connexions lorsque les ressources disponibles ne permettent pas de maintenir les niveaux prévus.
Sur les réseaux congestionnés, ces politiques aident à répartir la capacité en fonction des besoins des services. Elles ne créent pas de bande passante supplémentaire : elles déterminent l’utilisation de la capacité existante et le trafic qui bénéficie d’une priorité. Ainsi, donner une priorité plus élevée à une application peut laisser moins de ressources disponibles pour une autre.
Des technologies comme DiffServ permettent de classer ou de marquer les paquets afin d’appliquer des politiques différenciées. Pour que la priorisation soit efficace de bout en bout, les équipements et les segments de réseau concernés doivent pouvoir interpréter et respecter les politiques configurées. Si elle n’est appliquée que sur une partie du trajet, la priorité peut ne pas être maintenue sur le reste de la route.
Comment interpréter les métriques ensemble
Pour les équipes d’exploitation et de gestion, les métriques sont plus utiles lorsqu’elles sont mises en relation avec le service à protéger et avec la perception de l’utilisateur. Une visioconférence, par exemple, peut se dégrader en raison d’une latence élevée, de la gigue, de pertes de paquets ou d’une combinaison de ces facteurs. Augmenter la priorité du trafic peut aider en période de congestion, mais ne prouve pas à lui seul que le problème est résolu.
Une démarche opérationnelle pratique peut suivre cet ordre :
Identifier le service affecté et le moment où la dégradation se produit.
Examiner conjointement la latence, la gigue, la perte de paquets et l’utilisation de la capacité sur les segments concernés.
Vérifier les politiques de QoS et déterminer si les équipements réseau les appliquent tout au long du trajet.
Comparer les indicateurs à l’expérience observée, sans supposer qu’une seule métrique explique tous les problèmes.
La surveillance et l’analyse du trafic peuvent aider à localiser les goulots d’étranglement et à vérifier le bon fonctionnement des politiques. L’interprétation doit tenir compte du type d’application, du sens de transmission et des conditions dans lesquelles les données ont été recueillies.
Limites et difficultés de la gestion de la QoS
La configuration de la QoS peut être complexe et nécessite de coordonner les politiques entre les appareils et les technologies. En outre, les profils de trafic évoluent ; une configuration qui fonctionne pendant une période de faible charge peut donner un résultat différent lorsque la demande augmente. La compatibilité entre les équipements et l’application des politiques sur l’ensemble du trajet conditionnent également leur efficacité.
La QoS ne doit donc pas être considérée comme une garantie absolue d’une expérience donnée. C’est un outil de gestion des priorités et des ressources ; le résultat dépend de la capacité disponible, de la conception du réseau, de la configuration appliquée et des besoins propres à chaque service.
Une révision pratique pour détecter les déséquilibres, hiérarchiser les priorités et réaffecter les tâches selon la capacité réelle de l'équipe, et non seulement le nombre de tâches en attente.
Découvrez comment utiliser le diagramme SIPOC et les cartographies de flux pour aligner les équipes, définir le périmètre d'un processus et détecter les inefficacités dans votre PME sans tomber dans la bureaucratie excessive.
Un glossaire pratique de trois indicateurs essentiels pour analyser les prix et la demande, calculer les revenus par chambre disponible et éviter des conclusions incomplètes sur la performance.