Glossário de métricas de rede e QoS para gestores de telecomunicações
Latência, jitter, perda de pacotes e largura de banda descrevem diferentes aspetos do desempenho de uma rede. Este glossário explica como interpretá-los em conjunto com a QoS e a experiência do utilizador para orientar a gestão operacional.
A qualidade de serviço (QoS) reúne políticas e mecanismos de rede que classificam e priorizam o tráfego para gerir os recursos disponíveis e oferecer um desempenho mais previsível. É especialmente relevante quando diferentes aplicações partilham capacidade e têm necessidades distintas: uma chamada de voz é sensível aos atrasos, enquanto uma transferência de ficheiros costuma tolerá-los melhor.
A QoS descreve as condições técnicas da rede; a qualidade da experiência (QoE) refere-se à forma como o utilizador percebe o serviço. As métricas de rede podem ajudar a explicar uma experiência deficiente, mas não a representam por completo: a satisfação também depende da aplicação e das expectativas do utilizador.
Glossário das principais métricas
Largura de banda e débito
A largura de banda é a capacidade de transmissão disponível ou atribuída a uma ligação ou fluxo, normalmente expressa em bits por segundo, como Mbps ou Gbps. Não equivale necessariamente à velocidade obtida por cada aplicação: a capacidade partilhada, a congestão e a configuração da rede influenciam o resultado.
Para a gestão operacional, convém distinguir a capacidade da ligação do volume de dados efetivamente transmitido. Uma rede pode dispor de largura de banda suficiente e, ainda assim, oferecer uma má experiência se apresentar latência elevada, variações ou perdas.
Latência
A latência é o tempo que um pacote demora a viajar da origem ao destino. Pode aumentar, por exemplo, quando os pacotes aguardam em filas durante períodos de congestão. É habitualmente expressa em milissegundos (ms).
Como referências indicativas para aplicações interativas, a ManageEngine indica que, abaixo de 50 ms, o atraso costuma passar despercebido; entre 50 e 150 ms, podem surgir pausas percetíveis; e, acima de 150 ms, a conversa pode ser afetada de forma mais evidente. Estes não são limites universais: o impacto depende da aplicação, da rota e das condições de medição. Numa chamada, um atraso elevado pode dificultar a alternância entre interlocutores.
Jitter ou variação
O jitter, também designado por variação, descreve quanto o atraso entre pacotes varia. Não é o mesmo que latência: uma ligação pode ter um atraso médio moderado e, ainda assim, apresentar variações importantes entre pacotes sucessivos.
Esta variabilidade pode afetar o áudio e o vídeo em tempo real, porque os dados não chegam a um ritmo constante. Por isso, ao diagnosticar interrupções ou falhas numa videochamada, verificar apenas a latência média pode ser insuficiente.
Perda de pacotes
A perda de pacotes é a proporção de pacotes enviados que não chega ao destino. Pode interromper ou degradar as comunicações, sobretudo quando a aplicação precisa de receber dados de forma contínua. Deve ser observada em conjunto com a latência e o jitter: um valor isolado não explica, por si só, a causa nem o impacto para o utilizador.
Fiabilidade
A fiabilidade descreve a capacidade da rede para prestar o serviço de forma consistente e sem interrupções relevantes. É um conceito mais amplo do que uma medição pontual: a sua avaliação pode exigir a observação do comportamento da rede ao longo do tempo e em diferentes condições de carga.
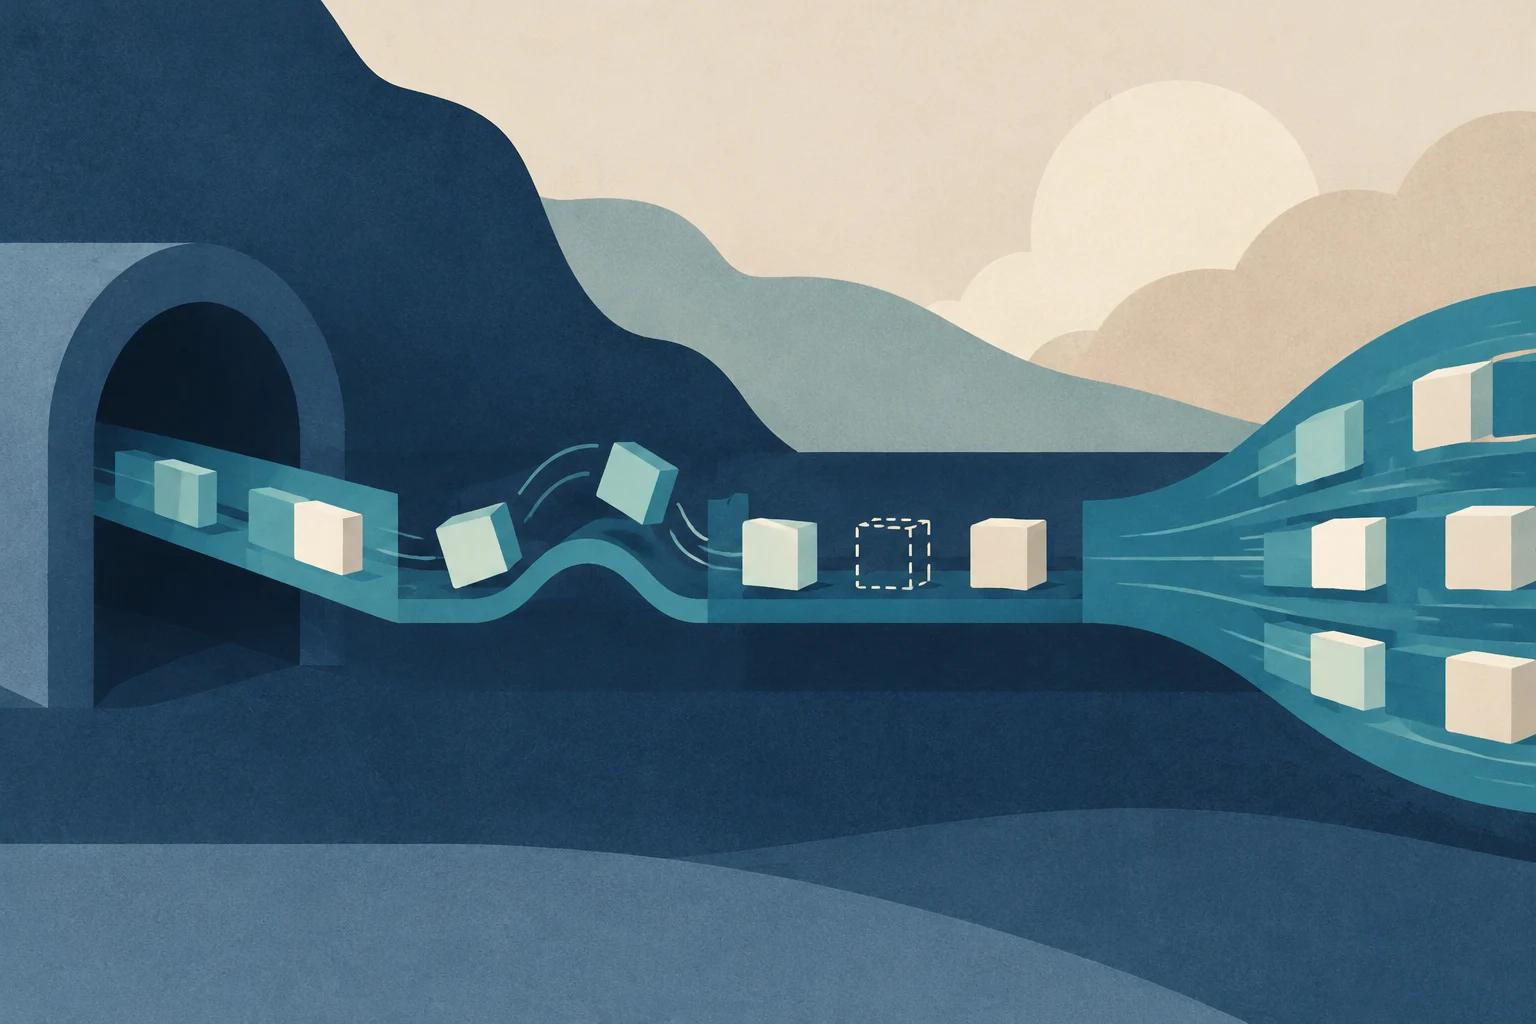
Ilustração conceptual gerada por IA · Edition Business
Mecanismos de QoS: como o tráfego é gerido
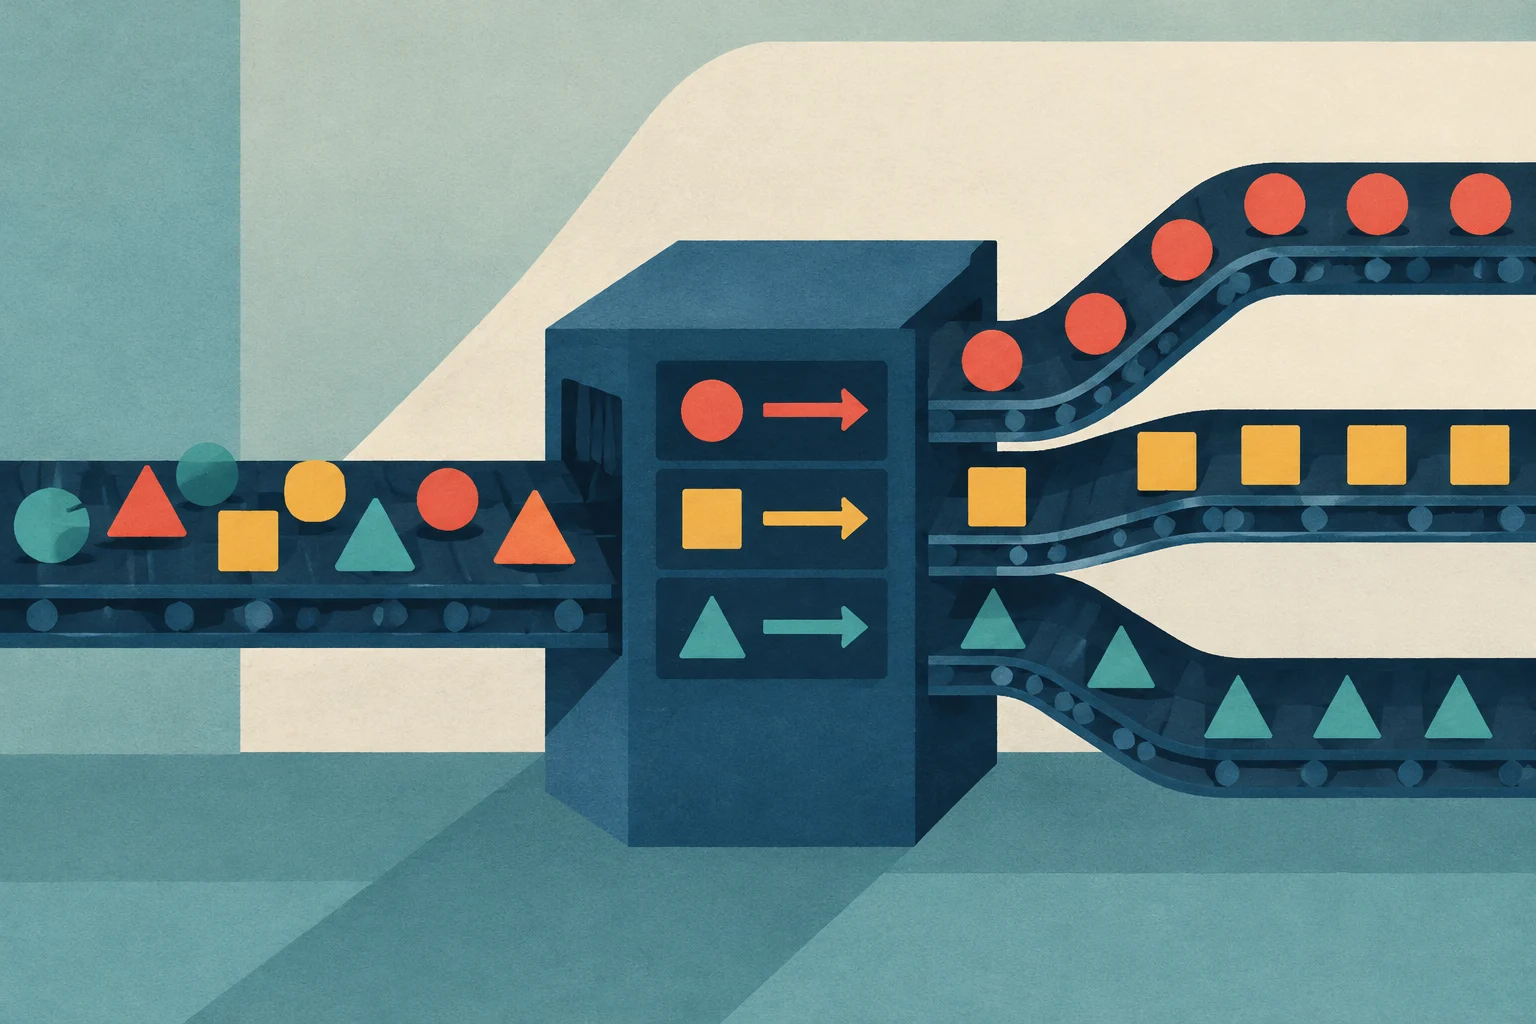
As redes podem aplicar classificação e priorização para tratar certos fluxos antes de outros. Também são utilizadas filas para ordenar pacotes, mecanismos de gestão do tráfego para regular o envio e controlos de admissão para limitar novas ligações quando os recursos disponíveis não permitem manter os níveis previstos.
Em redes congestionadas, estas políticas ajudam a distribuir a capacidade de acordo com as necessidades dos serviços. Não criam largura de banda adicional: determinam como a capacidade existente é utilizada e a que tráfego é dada prioridade. Assim, uma prioridade superior para uma aplicação pode implicar menos recursos disponíveis para outra.
Tecnologias como DiffServ permitem classificar ou marcar pacotes para aplicar políticas diferenciadas. Para que a priorização seja eficaz de ponta a ponta, os equipamentos e segmentos de rede relevantes têm de conseguir interpretar e respeitar as políticas configuradas. Se for aplicada apenas numa parte do percurso, o tratamento pode não ser mantido no restante trajeto.
Como interpretar as métricas em conjunto
Para as equipas de operações e gestão, as métricas são mais úteis quando relacionadas com o serviço que se pretende proteger e com a perceção do utilizador. Uma videoconferência, por exemplo, pode degradar-se devido a latência elevada, jitter, perda de pacotes ou a uma combinação destes fatores. Aumentar a prioridade do tráfego pode ajudar em momentos de congestão, mas não prova, por si só, que o problema esteja resolvido.
Uma leitura operacional prática pode seguir esta ordem:
Identificar o serviço afetado e quando ocorre a degradação.
Verificar em conjunto a latência, o jitter, a perda de pacotes e a utilização da capacidade nos segmentos relevantes.
Verificar as políticas de QoS e se os equipamentos de rede as aplicam ao longo da rota.
Comparar os indicadores com a experiência observada, sem pressupor que uma única métrica explica todos os problemas.
A monitorização e a análise do tráfego podem ajudar a localizar estrangulamentos e a verificar se as políticas estão a funcionar. A interpretação deve ter em conta o tipo de aplicação, o sentido da transmissão e as condições em que os dados foram recolhidos.
Limites e desafios da gestão de QoS
A configuração de QoS pode ser complexa e exige a coordenação de políticas entre dispositivos e tecnologias. Além disso, os padrões de tráfego mudam; uma configuração que funciona num período de baixa carga pode não produzir o mesmo resultado quando a procura aumenta. A compatibilidade entre equipamentos e a cobertura das políticas em toda a rota também condicionam a sua eficácia.
Por isso, a QoS não deve ser entendida como uma garantia absoluta de determinada experiência. É uma ferramenta para gerir prioridades e recursos; o resultado depende da capacidade disponível, do desenho da rede, da configuração aplicada e das necessidades específicas de cada serviço.
Uma revisão prática para detetar desequilíbrios, ordenar prioridades e reatribuir tarefas com base na capacidade real da equipa, e não apenas no número de pendências.
Descubra como usar o diagrama SIPOC e os mapas de fluxo para alinhar equipes, definir o âmbito de um processo e detetar ineficiências na sua PME sem cair em burocracia excessiva.
Um glossário prático de três indicadores essenciais para analisar preços e procura, calcular a receita por quarto disponível e evitar conclusões incompletas sobre o desempenho.