Glosario de métricas de red y QoS para gestores de telecomunicaciones
Latencia, jitter, pérdida de paquetes y ancho de banda describen aspectos distintos del rendimiento de una red. Este glosario explica cómo interpretarlos junto con la QoS y la experiencia del usuario para orientar la gestión operativa.
La calidad de servicio (QoS) reúne políticas y mecanismos de red que clasifican y priorizan el tráfico para gestionar los recursos disponibles y ofrecer un rendimiento más predecible. Es especialmente relevante cuando distintas aplicaciones comparten capacidad y tienen necesidades diferentes: una llamada de voz es sensible a los retrasos, mientras que una transferencia de archivos suele tolerarlos mejor.
La QoS describe condiciones técnicas de la red; la calidad de la experiencia (QoE) se refiere a cómo percibe el servicio la persona usuaria. Las métricas de red pueden ayudar a explicar una experiencia deficiente, pero no la representan por completo: la satisfacción también depende de la aplicación y de las expectativas del usuario.
Glosario de métricas principales
Ancho de banda y rendimiento
El ancho de banda es la capacidad de transmisión disponible o asignada a un enlace o flujo, normalmente expresada en bits por segundo, como Mbps o Gbps. No equivale necesariamente a la velocidad que obtiene cada aplicación: la capacidad compartida, la congestión y la configuración de la red influyen en el resultado.
Para la gestión operativa, conviene distinguir la capacidad del enlace del volumen de datos que se transmite efectivamente. Una red puede disponer de ancho de banda suficiente y aun así ofrecer una mala experiencia si presenta alta latencia, fluctuaciones o pérdidas.
Latencia
La latencia es el tiempo que tarda un paquete en viajar desde el origen hasta el destino. Puede aumentar, por ejemplo, cuando los paquetes esperan en colas durante periodos de congestión. Se expresa habitualmente en milisegundos (ms).
Como referencias orientativas para aplicaciones interactivas, ManageEngine señala que por debajo de 50 ms el retraso suele pasar inadvertido; entre 50 y 150 ms pueden aparecer pausas perceptibles, y por encima de 150 ms la conversación puede verse afectada de forma más evidente. No son límites universales: el impacto depende de la aplicación, la ruta y las condiciones de medición. En una llamada, un retraso elevado puede dificultar que las personas se turnen al hablar.
Jitter o fluctuación
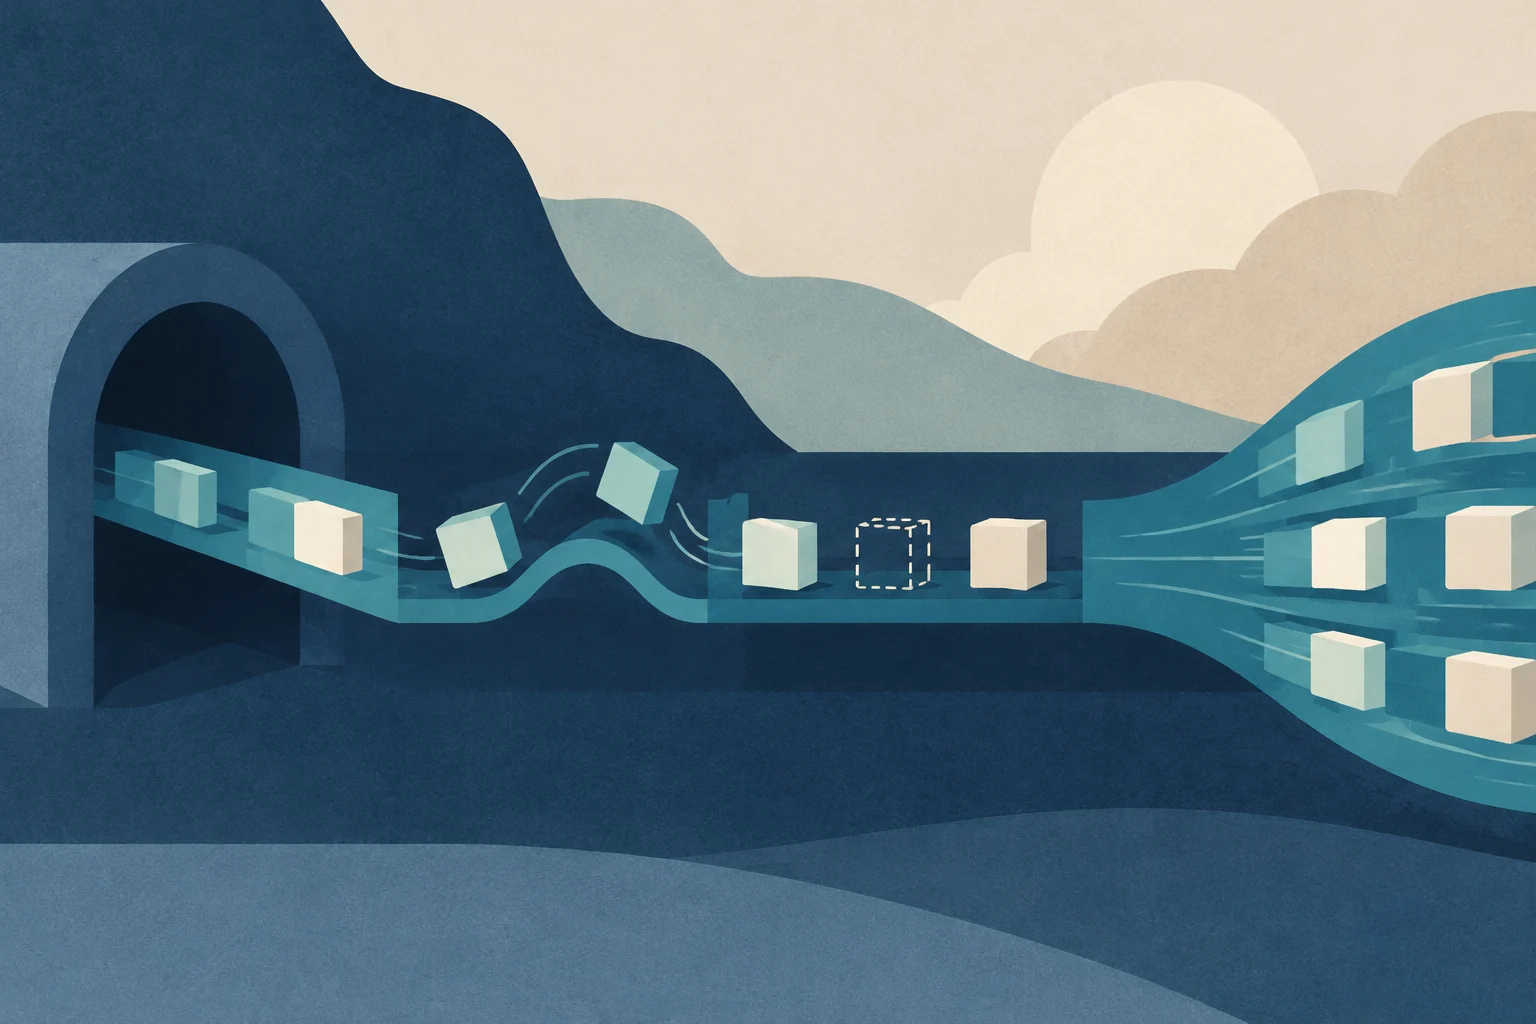
El jitter, también llamado fluctuación, describe cuánto varía el retraso entre paquetes. No es lo mismo que la latencia: una conexión puede tener un retraso medio moderado y, sin embargo, variaciones importantes entre paquetes sucesivos.
Esta variabilidad puede afectar el audio y el vídeo en tiempo real, porque los datos no llegan con un ritmo constante. Por eso, al diagnosticar cortes o saltos en una videollamada, revisar solo la latencia media puede ser insuficiente.
Pérdida de paquetes
La pérdida de paquetes es la proporción de paquetes enviados que no llega a su destino. Puede interrumpir o degradar las comunicaciones, especialmente cuando la aplicación necesita recibir datos de forma continua. Debe observarse junto con la latencia y el jitter: una cifra aislada no explica por sí sola la causa ni el impacto sobre el usuario.
Fiabilidad
La fiabilidad describe la capacidad de la red para prestar el servicio de forma consistente y sin interrupciones relevantes. Es un concepto más amplio que una medición puntual: su evaluación puede requerir observar el comportamiento de la red a lo largo del tiempo y en distintas condiciones de carga.
Ilustración conceptual generada con IA · Edition Business
Mecanismos de QoS: cómo se gestiona el tráfico
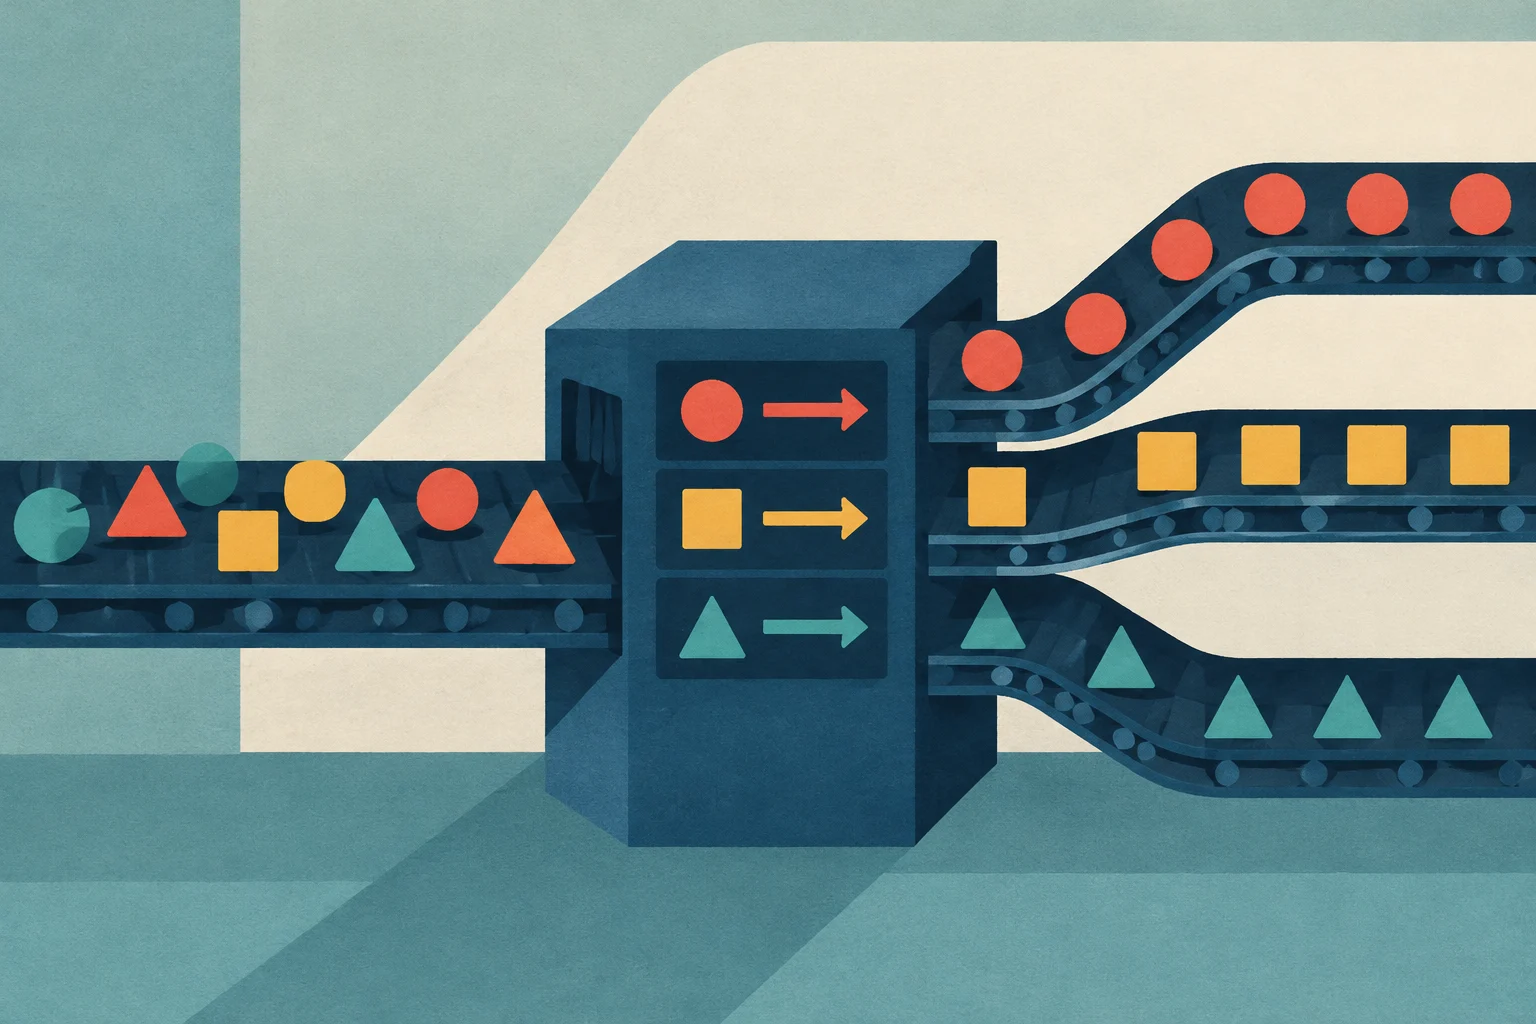
Las redes pueden aplicar clasificación y priorización para tratar ciertos flujos antes que otros. También se utilizan colas para ordenar paquetes, mecanismos de gestión del tráfico para regular el envío y controles de admisión para limitar nuevas conexiones cuando los recursos disponibles no permiten mantener los niveles previstos.
En redes congestionadas, estas políticas ayudan a repartir la capacidad según las necesidades de los servicios. No crean ancho de banda adicional: determinan cómo se utiliza la capacidad existente y qué tráfico recibe preferencia. Por tanto, una prioridad mayor para una aplicación puede implicar menos recursos disponibles para otra.
Tecnologías como DiffServ permiten clasificar o marcar paquetes para aplicar políticas diferenciadas. Para que la priorización sea efectiva de extremo a extremo, los equipos y tramos de red pertinentes deben poder interpretar y respetar las políticas configuradas. Si se aplica solo en una parte del recorrido, el tratamiento puede no mantenerse en el resto de la ruta.
Cómo interpretar las métricas en conjunto
Para equipos de operaciones y gestión, las métricas son más útiles cuando se relacionan con el servicio que se quiere proteger y con la percepción del usuario. Una videoconferencia, por ejemplo, puede degradarse por latencia alta, jitter, pérdida de paquetes o una combinación de estos factores. Aumentar la prioridad del tráfico puede ayudar en momentos de congestión, pero no demuestra por sí solo que el problema esté resuelto.
Una lectura operativa práctica puede seguir este orden:
Identificar el servicio afectado y cuándo se produce la degradación.
Revisar conjuntamente latencia, jitter, pérdida de paquetes y uso de capacidad en los tramos pertinentes.
Comprobar las políticas de QoS y si los equipos de red las aplican a lo largo de la ruta.
Contrastar los indicadores con la experiencia observada, sin asumir que una única métrica explica todos los problemas.
La monitorización y el análisis del tráfico pueden ayudar a localizar cuellos de botella y comprobar si las políticas están funcionando. La interpretación debe considerar el tipo de aplicación, el sentido de transmisión y las condiciones en que se recogieron los datos.
Límites y retos de la gestión de QoS
La configuración de QoS puede resultar compleja y exige coordinar políticas entre dispositivos y tecnologías. Además, los patrones de tráfico cambian; una configuración que funciona en un periodo de baja carga puede no dar el mismo resultado cuando aumenta la demanda. La compatibilidad entre equipos y la cobertura de las políticas en toda la ruta también condicionan su eficacia.
Por ello, QoS no debe entenderse como garantía absoluta de una experiencia determinada. Es una herramienta para gestionar prioridades y recursos; el resultado depende de la capacidad disponible, el diseño de la red, la configuración aplicada y las necesidades concretas de cada servicio.
Una revisión práctica para detectar desequilibrios, ordenar prioridades y reasignar tareas según la capacidad real del equipo, no solo el número de pendientes.
Descubre cómo utilizar el diagrama SIPOC y los mapas de flujo para alinear equipos, definir el alcance de un proceso y detectar ineficiencias en tu pyme sin caer en la burocracia excesiva.
Un glosario práctico de tres indicadores esenciales para analizar precios y demanda, calcular ingresos por habitación disponible y evitar conclusiones incompletas sobre el rendimiento.